
你有莫得思过,为什么机器东谈主学一个新行为这样难?
东谈主类学作念一件事,比如把杯子放进微波炉再关上门,可能看一遍视频就会了。但机器东谈主不行。它得先摸索几十次致使几百次,撞坏几个杯子,能力拼集学会。况且每次撞坏蛋,王人得有东谈主在傍边盯着,再行摆好场景,再行来一遍。这个过程慢、贵、还危急。
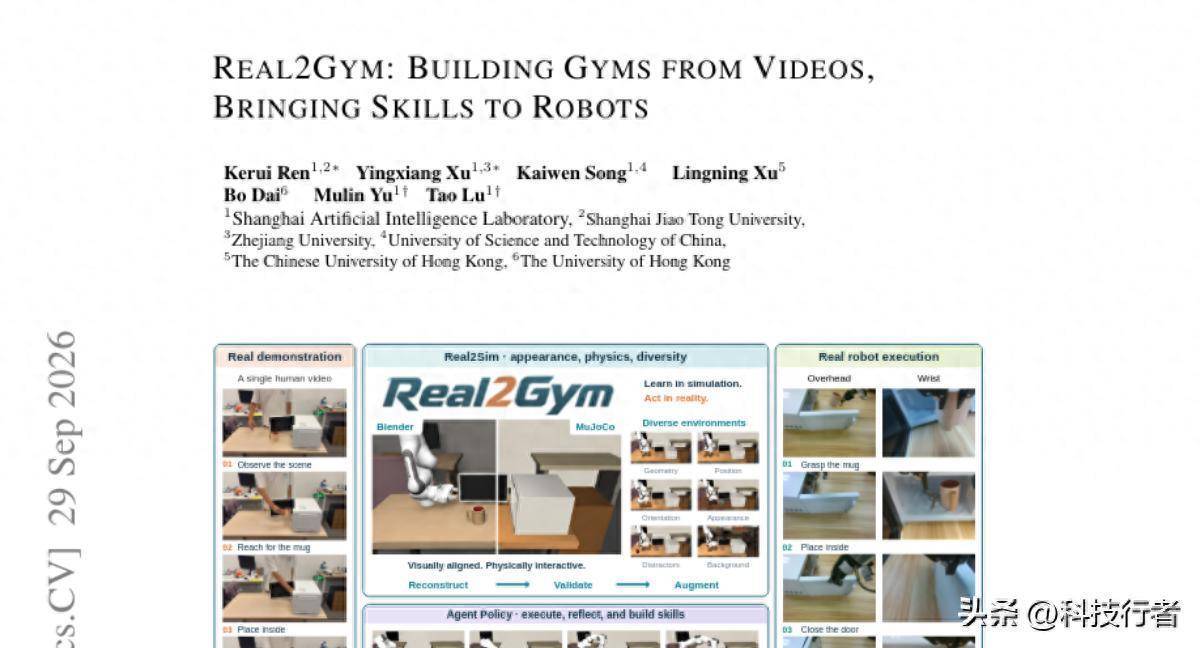
这即是Real2Gym这篇论文思措置的问题:能不行让机器东谈主像东谈主雷同,看一段视频就学会一个手段,况且统统这个词学习过程无须在真确全国里反复试错,而是先在假造环境里练熟了,再搬到履行中一次奏效。
**试错的代价,比你思象的更贵**
先说说为什么机器东谈主不行像强化学习那样豪恣试错。思象你在教机器东谈垄断杯子,每次它失败一次,你就得再行把杯子摆回原位,再行启动机械臂,再行查验有莫得损坏,这一套历程下来可能要几分钟。若是需要试错一千次能力学会,那即是几十个小时的纯东谈主工值守时间,还不算杯子摔碎的资本。
强化学习*:一种机器学习形势,通过让智能体不断尝试行为并左证效果反应出动战略,最终学会完成任务。
论文里提到,物理全国里试错还有个荫藏问题:失败之后时时很难把场景复兴到失败前的情景。比如机械臂持杯子没持稳,杯子摔到地上碎了,你没法让摔碎的杯子"收复",只可换一个新的。这在仿真里统统不是问题,一个reset()请示,场景一会儿回到运作事态。
是以谜底很当然:把试错这件事挪到仿真里作念。这不是什么新思法体育游戏app平台,强化学习圈子里早就在用仿真查考机器东谈主了。但问题在于,仿真环境和履行全国的差距,业内叫"Sim2Real gap